
실제 이메일 시퀀스 151개를 각 메시지가 도착한 날짜와 함께 담았어요. 둘러보고, 하나를 리믹스해 자동화 초안으로 만들거나, API와 MCP로 코드에서 모두 읽어 보세요.

대부분의 템플릿 갤러리는 이메일을 한 번에 한 통씩 보여 줘요. 그런데 이게 가장 쓸모가 적은 단위예요. 웰컴 이메일 한 통만 봐서는 그 앞뒤의 타이밍이나 맥락을 알 수 없어요. 시퀀스를 보면 그 맥락이 보여요. 물론 시퀀스를 봤다고 해서 그 시퀀스가 좋은 성과를 냈다는 증거가 되지는 않아요.
그래서 저희는 수집한 시퀀스를 그대로 보관했어요. Brew의 플로우는 가입이나 뉴스레터 구독 뒤에 저희가 받은 이메일을 순서대로, 각 이메일이 도착한 날짜와 함께 보여 줘요. 수집 한도 때문에 시퀀스 전체가 담기지 않았을 수도 있어요. 9월 17일 출시 당시 갤러리에는 플로우 151개가 있었어요. 아래 수치는 출시 시점의 스냅샷 기준이고, 현재 카탈로그는 바뀔 수 있어요.
GET /v1/flows 엔드포인트와 list_flows MCP 도구는 같은 레코드를 반환해요. 그래서 에이전트는 사람이 아무것도 클릭하지 않아도 시퀀스 151개를 모두 살펴볼 수 있어요.emailId 값이 있고, 이 값을 create_email 도구에 referenceEmailId 값으로 바로 넘길 수 있어요.Zapier의 가입 후 시퀀스는 10.7일 동안 이메일 8통을 보내요:
| 일 차 | 제목 |
|---|---|
| 0 | Welcome aboard 👋 | Let's make some magic with AI |
| 1 | Why you should ditch spreadsheets for Tables |
| 2 | Build your first Zap workflow with Copilot ⚡ |
| 3 | What engineers are automating this week |
| 5 | Put AI to work for you |
| 9 | Go beyond workflows 🚀 |
| 10 | Stuck? Or need automation ideas? |
| 10.7 | Your Zapier trial ends in three days ⏲️ |
제목만 보지 말고 날짜를 보세요. 이메일 4통이 나흘 연속 아침마다 도착한 뒤, 간격이 이틀로, 다시 나흘로 벌어져요. “Stuck?” 이메일은 10일 차에 도착하고, 체험 종료 이메일은 그로부터 17시간 뒤에 이어져요. 페이월을 앞두고 마지막으로 건넬 수 있는 쓸모 있는 것은 도움을 주겠다는 제안이고, 두 이메일은 거의 붙어 있어야 한다고 누군가 판단한 거예요.
이메일 한 통의 스크린샷으로는 이런 걸 볼 수 없어요.
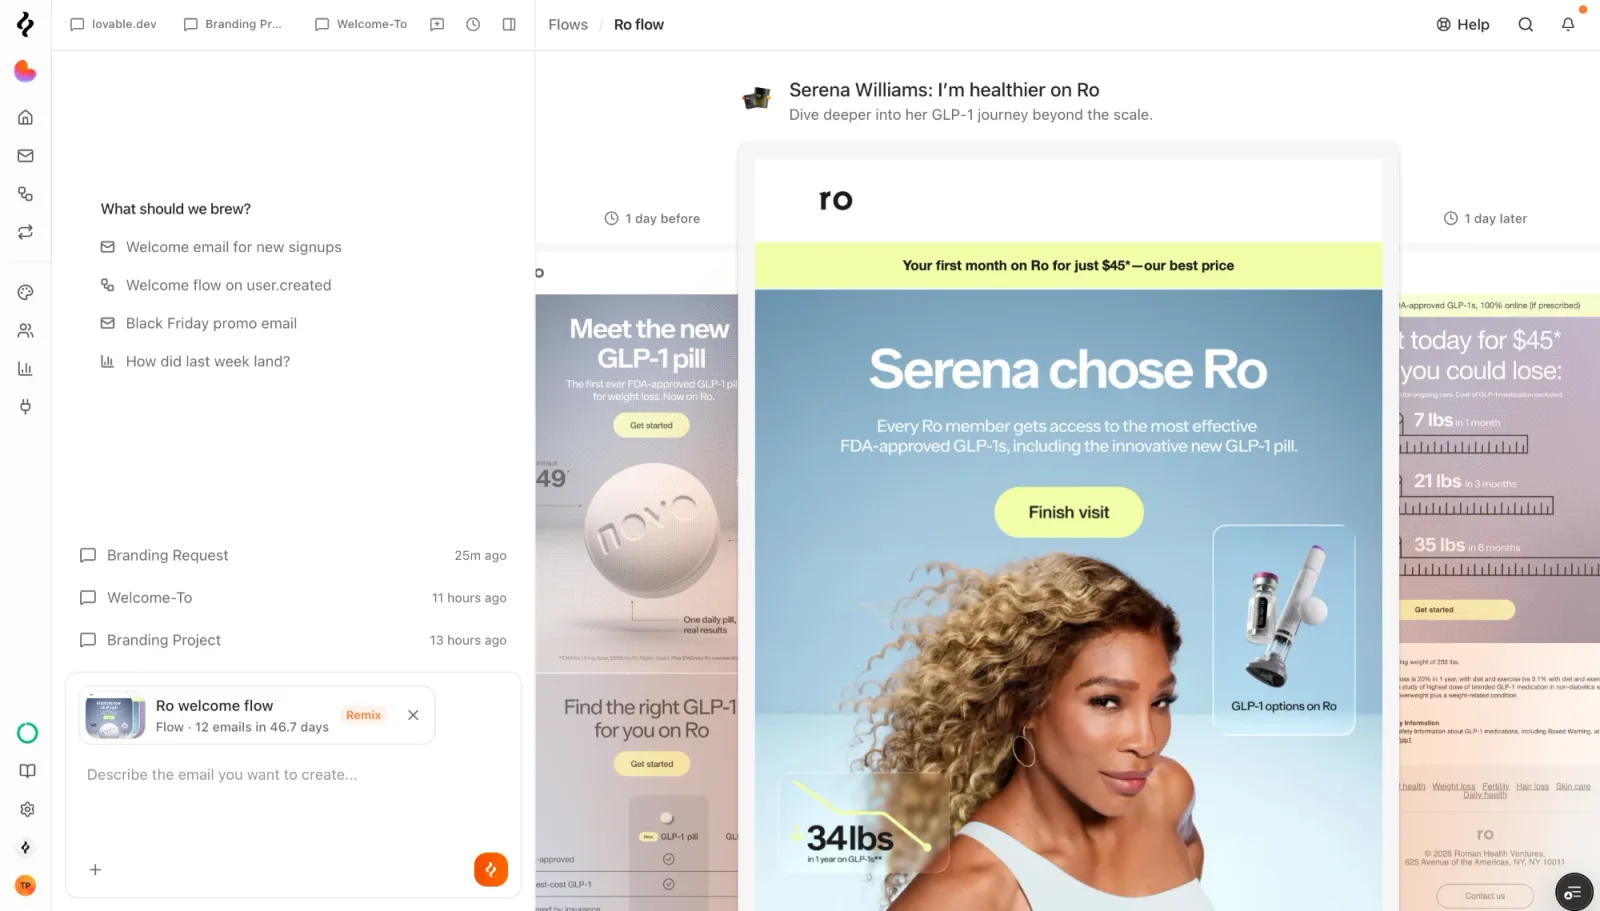
플로우 뷰어는 첫 이메일부터 보여 주는데, 첫 이메일에는 뒤쪽 대기 시간만 표시돼요. 위의 Ro 시퀀스처럼 중간 단계로 들어가면 앞뒤 간격이 모두 보여요. Ro의 웰컴 플로우는 46.7일 동안 이메일 12통을 보내는, Zapier보다 느린 흐름이에요. 제목을 하나도 읽기 전에 간격만 보고도 알 수 있어요.
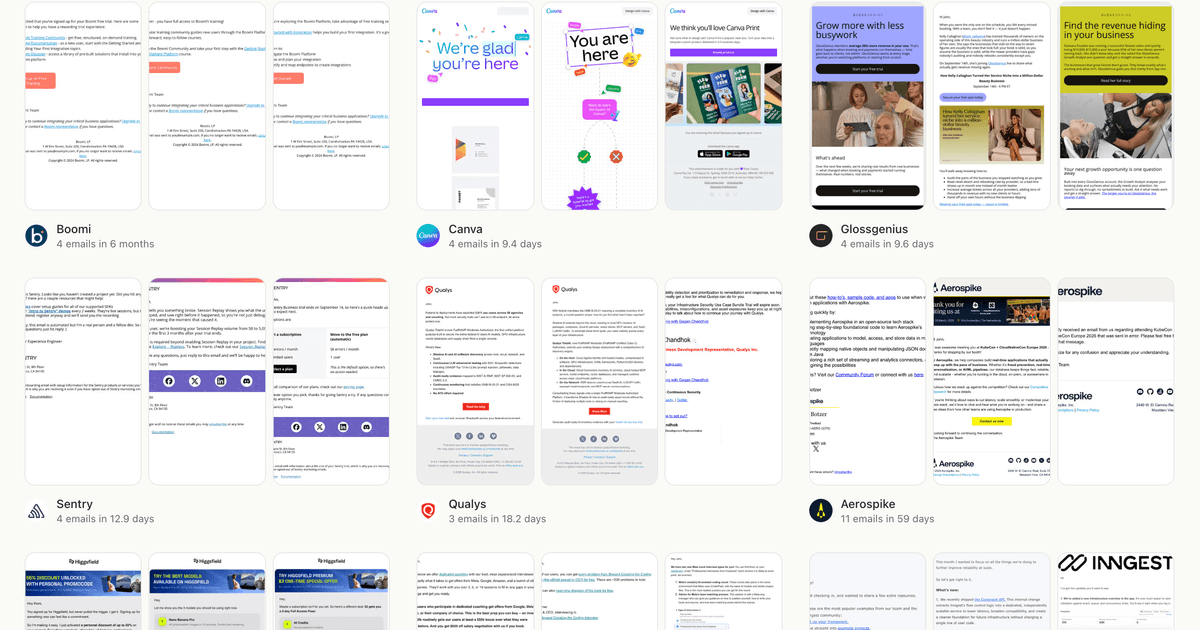
각 단계에는 제목, 미리보기 텍스트, 도착한 날짜, 직전 발송 이후의 대기 시간, 카테고리, 미리보기 이미지가 담겨 있어요. 요청하면 렌더링된 HTML도 받을 수 있어요.
수집한 데이터는 브랜드당 시퀀스 하나라서, 플로우 151개는 곧 회사 151곳이에요:
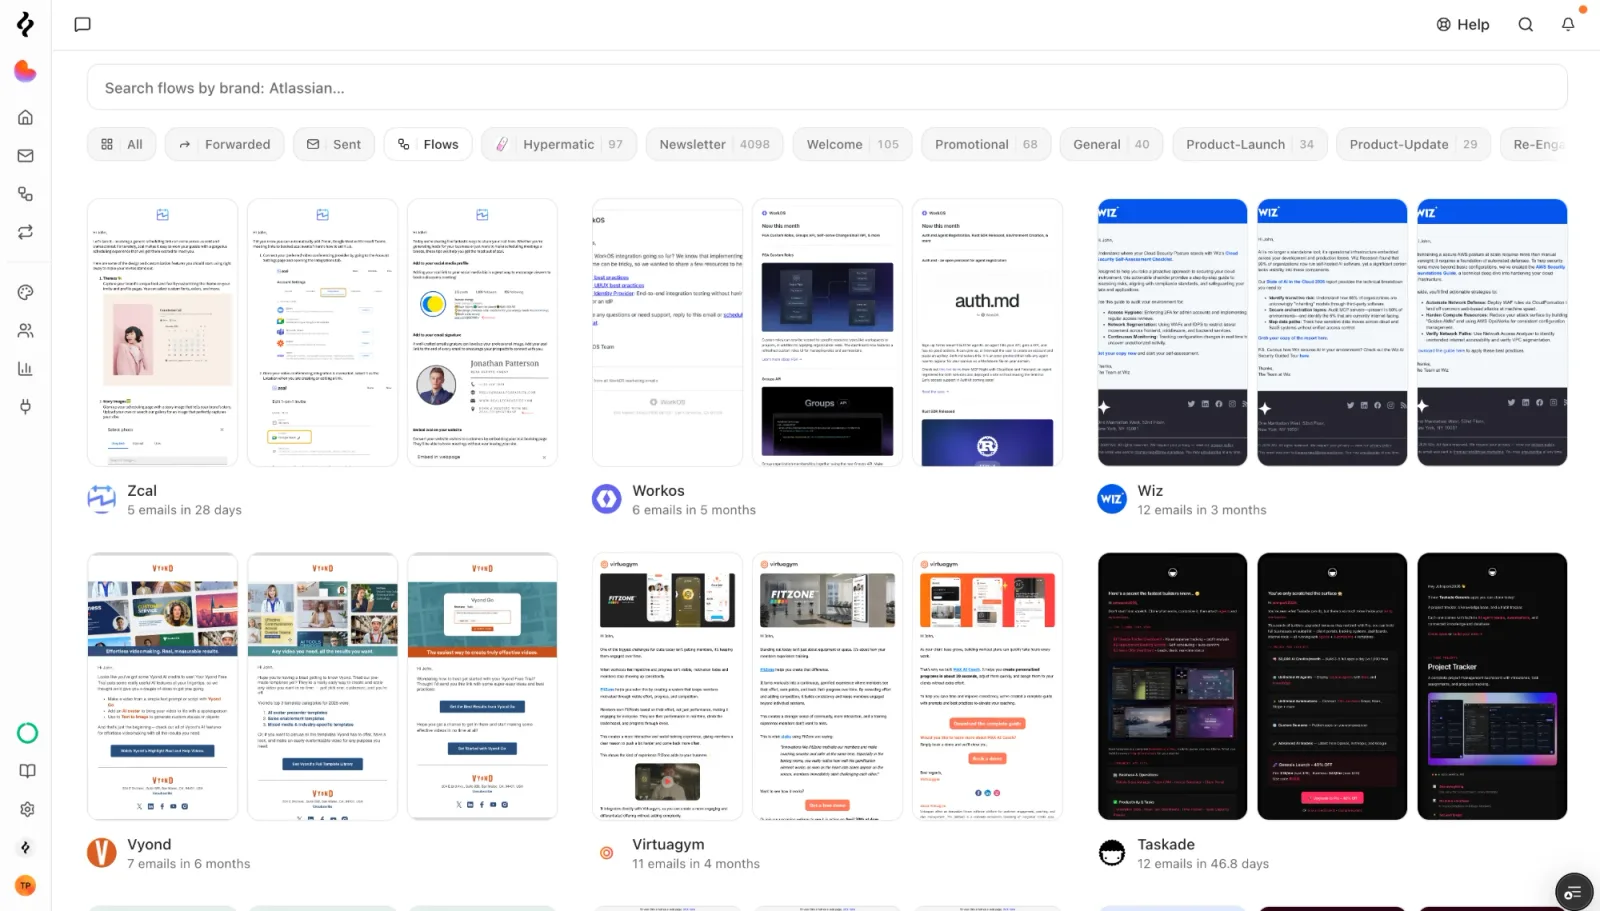
이와 별도로 개별 디자인 갤러리에는 뉴스레터 4,098개, 웰컴 이메일 105개, 프로모션 이메일 68개가 더 있어요. 순서를 알려 주는 건 플로우 쪽이에요.
리믹스라고 하면 다들 복사를 떠올려요. 하지만 그렇지 않아요.
Brew는 먼저 자동화 그래프를 만들어요. 내 트리거를 두고, 원본 플로우의 간격을 대기 노드로 넣고, 단계마다 발송 노드를 하나씩 둬요. 이 절반은 생성이 아니라 계산이에요. 네 번째 이메일이 3일 차에 나간다는 걸 모델에게 추측하라고 하지 않아요.
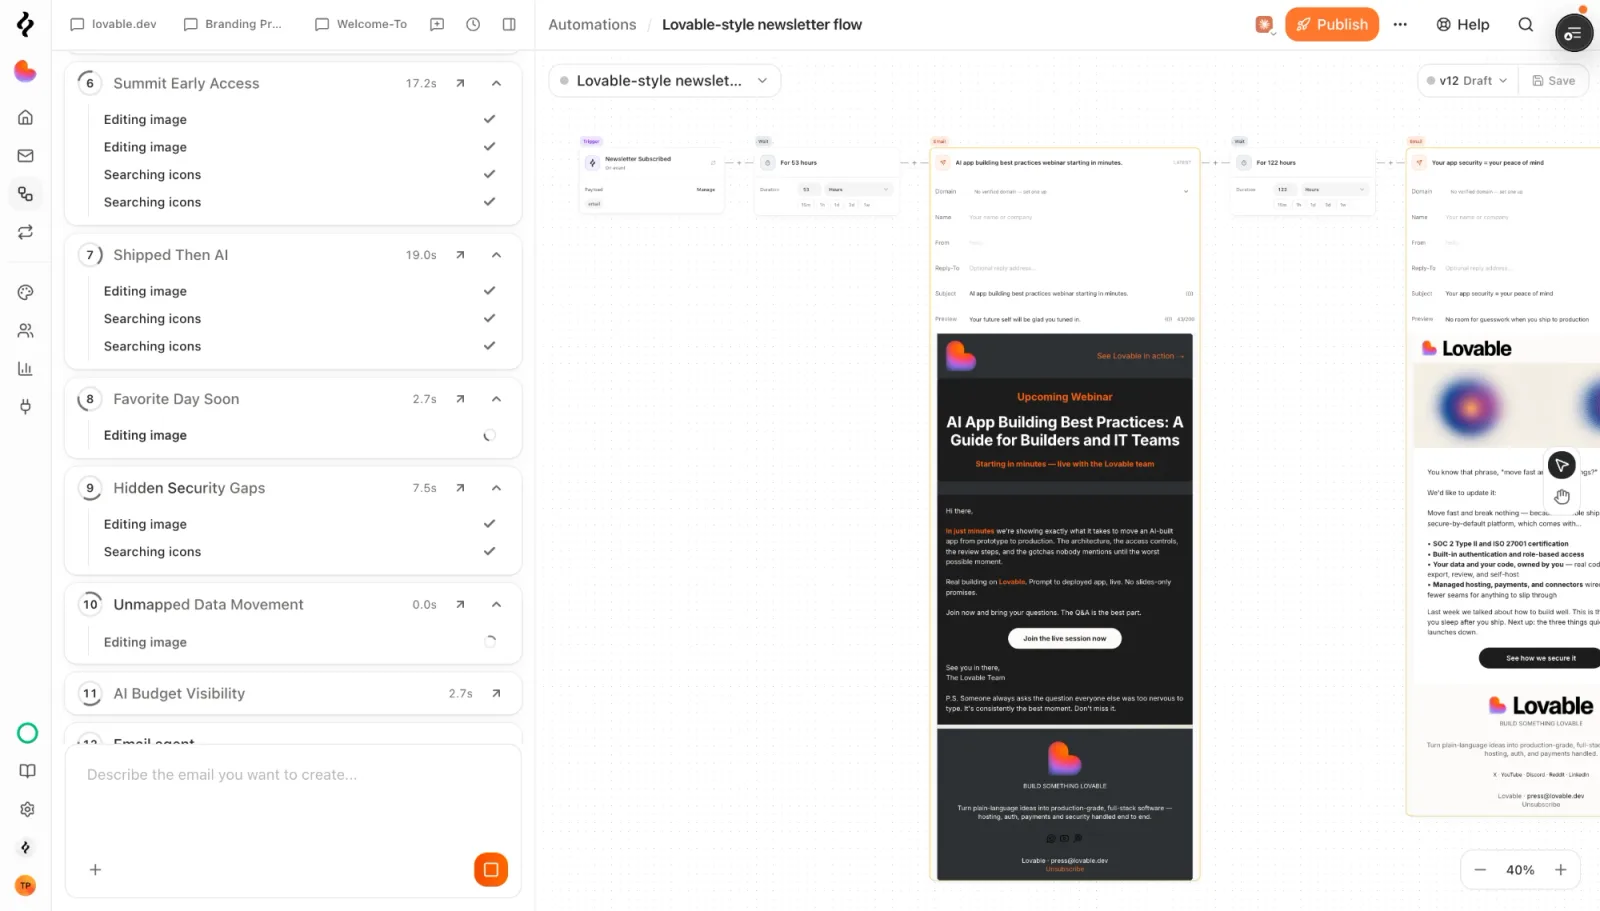
대기 노드가 53시간, 122시간인 건 원본 브랜드가 실제로 그 간격으로 보냈기 때문이에요. 시간 단위로 반올림한 값이죠. 정확히 하루 단위인 간격은 그대로 하루 단위로 남고, 1시간 미만은 1시간이 돼요. 생성되는 건 이메일뿐이고, 이메일은 각각 내 브랜드를 기준으로 동시에 생성돼요. 내 색상, 내 폰트, 내 보이스, 내 제품으로요. 각 단계에는 시퀀스 안에서 그 이메일이 맡은 역할과 앞뒤에 어떤 이메일이 있는지를 설명하는 브리프도 함께 들어가요. 이메일을 쓰는 하위 에이전트들은 서로의 작업을 볼 수 없어서, 브리프가 없으면 같은 일정에 맞춰 서로 상관없는 메시지 8개를 만들어 버리거든요.
그 결과, 실제 회사가 이미 운영해 본 시퀀스의 발송 간격에 내 카피를 담은 자동화 초안이 생겨요. 그래도 직접 읽어 봐야 해요. 브랜드에 맞게 바꾼 결과물은 좋지만, 완성본은 아니에요.
모든 플로우는 REST API와 MCP로 제공되므로, 에이전트가 이 데이터를 직접 읽을 수 있어요.
# First page, newest first
curl "https://brew.new/api/v1/flows" \
  -H "Authorization: Bearer $BREW_API_KEY"

# One sequence, every step
curl "https://brew.new/api/v1/flows/zapier.com" \
-H "Authorization: Bearer $BREW_API_KEY"brand, category, type(signup 또는 newsletter) 값으로 필터링할 수 있어요. 이메일 수가 가장 많은 시퀀스는 emails, 가장 여러 날에 걸쳐 이어지는 시퀀스는 span, 다른 사람들이 따라 할 만하다고 본 시퀀스는 remixes 기준으로 정렬하세요. semantic 파라미터를 넘기면 시퀀스의 주제로 검색할 수 있어요. 어느 브랜드가 썼는지 몰라도 체험 종료 윈백 시퀀스를 찾을 수 있는 방법이에요.
Brew MCP 서버에서는 같은 읽기 기능을 도구와 리소스로 제공해요:
list_flows                      # the list, same filters and sorts
get_flow { slug: "zapier.com" } # one sequence with every step
brew://flows                    # @-mentionable in a chat
REST와 MCP는 같은 공개 카탈로그를 읽어요. 플로우는 조직 단위로 제공되므로 이런 읽기 요청에는 브랜드를 지정하지 않아요. 목록을 페이지별로 가져오려면, 반환된 pagination.cursor 값이 null이 될 때까지 그 값을 다음 요청의 cursor 값으로 넘기세요. 목록 요청 한 번으로 카탈로그 전체를 받을 수는 없지만, total 값은 쿼리에 일치하는 모든 플로우의 수를 알려 줘요.
에이전트는 참고할 이메일을 고르기 전에 시퀀스를 살펴볼 수 있어요.
어떤 가입 플로우가 첫 이메일에 할인을 넣고, 어떤 플로우가 체험이 거의 끝날 때까지 기다릴까요? 개발자 도구는 2일 차에 무엇을 보낼까요? 뉴스레터 웰컴 시퀀스는 얼마나 이어지다 멈출까요? 혜택이 아니라 질문으로 시작하는 시퀀스는 몇 개나 될까요? 에이전트는 레코드의 steps[] 배열을 읽으며 이런 질문을 살펴볼 수 있어요. 다만 제목과 콘텐츠 분석에는 여전히 해석이 필요하고, API가 모든 질문에 맞는 필터를 제공하지는 않아요.
이 데이터를 실제로 쓸 수 있는 참고 자료로 만들어 주는 연결 고리는 단계마다 있는 emailId 값이에요. 템플릿 갤러리가 쓰는 것과 같은 참조이고, create_email 도구가 referenceEmailId 값으로 받는 바로 그 값이에요. 그래서 에이전트는 전체 흐름을 읽고, 중요한 단계를 고른 다음, 그 이메일 한 통을 디자인 도구에 넘겨요:
get_flow { slug: "zapier.com" }
  → steps[4].emailId = "pt1_k97hmahabyjrp1yfmga8m1rhah8e572q"

create_email {
  referenceEmailId: "pt1_k97hmahabyjrp1yfmga8m1rhah8e572q",
  prompt: "day-5 activation email for our API product"
}
흐름을 살펴보고, 필요한 이메일을 골라, 내 버전을 만드세요. 중간에 복사해 붙여 넣을 필요가 없어요.
수집은 플로우당 최대 12통까지만 하고 나머지는 잘라 내요. 그래서 emailCount: 12 값은 정확히 12통이 아니라 12통 이상 발송됐다는 뜻이에요. 앞에서 말한 플로우 59개가 여기에 해당해요.
렌더링된 이메일은 용량이 커요. MCP로 HTML을 요청하면 응답이 가득 차기 전에 처음 한두 단계만 HTML이 담기고, 나머지는 HTML 없이 와요. 몇 개가 담겼는지는 요약에 나와요. REST 경로에는 이런 한도가 없으니, 모든 본문이 필요하면 REST로 플로우를 읽으세요: GET /v1/flows/zapier.com?include=html.
무언가를 쓰기 전에 갤러리를 열고 내 카테고리의 시퀀스 세 개를 읽어 보세요. 그런 다음 우리 팀에 자신 있게 설명할 수 있는 발송 간격을 가진 시퀀스를 리믹스하고, 맞지 않는 부분을 고치세요.
에이전트에게 이 데이터를 맡긴다면, 인수 없이 list_flows 도구를 호출하는 게 올바른 첫 단계예요. 이 도구는 슬러그가 담긴 카드를 반환하고, get_flow 도구는 슬러그만 있으면 나머지 모든 정보를 가져와요. 전체 필드 목록은 API 레퍼런스에 있어요.
가입이나 뉴스레터 구독 한 번 뒤에 한 브랜드가 보낸 모든 이메일을, 순서대로, 그 트리거로부터 며칠 뒤에 도착했는지와 함께 담은 거예요. 플로우는 브랜드당 하나이고, 플로우의 슬러그는 브랜드의 도메인이에요.
아니요. Brew는 구조, 즉 단계 수, 순서, 간격을 복사하고, 간격은 시간 단위로 반올림해 재현해요. 그다음 원본 디자인을 참고해 모든 이메일을 내 브랜드에 맞게 다시 만들기 때문에, 결과물에는 내 색상, 폰트, 보이스가 담겨요.
REST로 읽으려면 templates.read 범위가 있는 API 키가 필요해요. MCP는 OAuth나 적절한 권한이 있는 API 키를 지원해요. 갤러리 자체는 공개되어 있어 계정이 없어도 돼요.
최대 12통이에요. 처음 12통만 수집하고 나머지는 잘라 내기 때문에, 이메일이 12통으로 표시된 플로우는 실제로 더 길게 이어졌을 수 있어요. 공개된 플로우 151개 중 59개가 이 한도에 걸려 있어요.
네. 플로우 하나를 읽을 때 include=html 옵션을 붙이면 돼요. MCP에서는 응답 하나에 처음 한두 단계만 들어가고, 몇 개가 담겼는지는 요약에 나와요. REST 경로는 모든 본문을 반환해요.

