
ลำดับอีเมลจริง 151 ชุด พร้อมวันที่อีเมลแต่ละฉบับมาถึง เลือกดู รีมิกซ์เป็นระบบอัตโนมัติฉบับร่าง หรืออ่านทั้งหมดจากโค้ดผ่าน API และ MCP

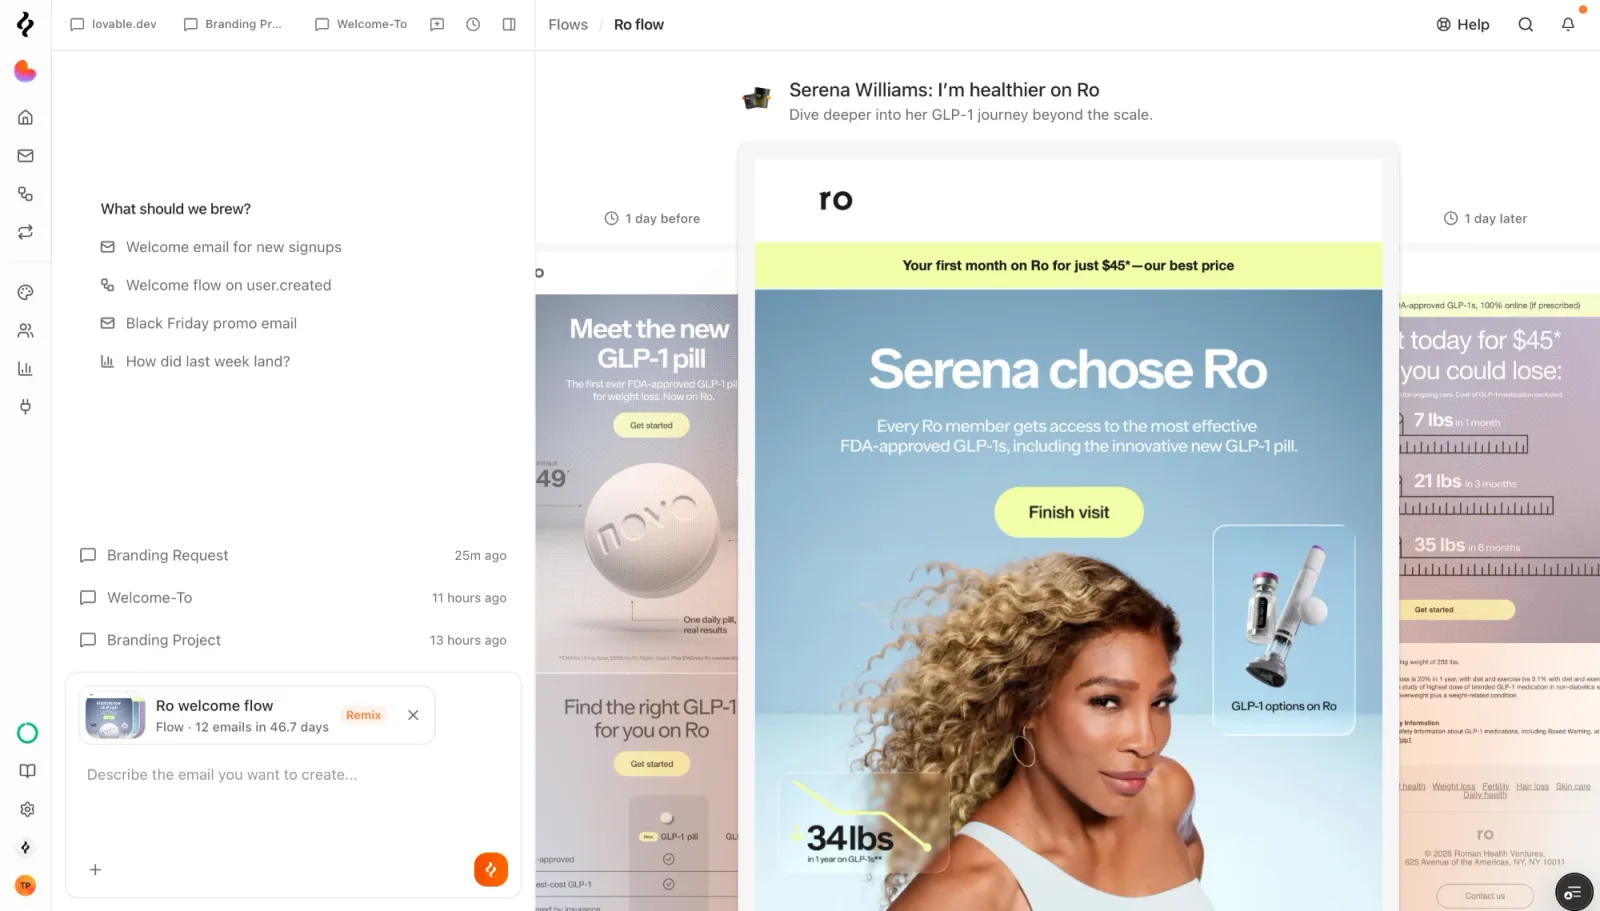
แกลเลอรีเทมเพลตส่วนใหญ่ให้คุณดูอีเมลทีละฉบับ ซึ่งเป็นหน่วยที่มีประโยชน์น้อยที่สุด อีเมลต้อนรับฉบับเดียวไม่ได้บอกจังหวะเวลาหรือบริบทรอบตัวมัน ลำดับอีเมลจะเติมบริบทนั้นให้ แม้ว่าการได้เห็นลำดับอีเมลจะไม่ได้พิสูจน์ว่าลำดับนั้นได้ผลดีก็ตาม
เราจึงเก็บลำดับอีเมลที่บันทึกมาไว้ทั้งชุด โฟลว์ใน Brew แสดงอีเมลที่เราพบหลังการสมัครใช้งานหรือการสมัครรับจดหมายข่าว เรียงตามลำดับ พร้อมวันที่อีเมลแต่ละฉบับมาถึง ด้วยข้อจำกัดของการเก็บอีเมล โฟลว์จึงอาจไม่ครบทั้งลำดับ ตอนเปิดตัวเมื่อวันที่ 17 กันยายน แกลเลอรีมีโฟลว์ 151 รายการ ตัวเลขด้านล่างอธิบายสแนปช็อต ณ วันเปิดตัวนั้น ส่วนแคตตาล็อกปัจจุบันบนเว็บไซต์อาจเปลี่ยนไป
GET /v1/flows และเครื่องมือ MCP list_flows ส่งคืนข้อมูลชุดเดียวกัน เอเจนต์จึงศึกษาลำดับอีเมลทั้ง 151 ชุดได้โดยไม่ต้องมีคนคลิกอะไรเลยemailId ที่ส่งต่อให้ create_email เป็น referenceEmailId ได้ทันทีลำดับอีเมลหลังสมัครของ Zapier มีอีเมล 8 ฉบับในเวลา 10.7 วัน:
| วัน | หัวเรื่อง |
|---|---|
| 0 | Welcome aboard 👋 | Let's make some magic with AI |
| 1 | Why you should ditch spreadsheets for Tables |
| 2 | Build your first Zap workflow with Copilot ⚡ |
| 3 | What engineers are automating this week |
| 5 | Put AI to work for you |
| 9 | Go beyond workflows 🚀 |
| 10 | Stuck? Or need automation ideas? |
| 10.7 | Your Zapier trial ends in three days ⏲️ |
อ่านวันด้วย ไม่ใช่แค่หัวเรื่อง อีเมล 4 ฉบับแรกมาถึงทุกเช้าติดต่อกัน จากนั้นช่วงห่างขยายเป็น 2 วัน แล้วเป็น 4 วัน อีเมล “Stuck?” มาถึงในวันที่ 10 และอีเมลแจ้งช่วงทดลองใช้ใกล้สิ้นสุดตามมาในอีก 17 ชั่วโมง มีคนตัดสินใจไว้แล้วว่าสิ่งสุดท้ายที่มีประโยชน์ก่อนถึงเพย์วอลล์คือการเสนอความช่วยเหลือ และอีเมลทั้งสองฉบับควรมาแทบจะติดกัน
สิ่งนี้คุณมองไม่เห็นจากภาพหน้าจอของอีเมลฉบับเดียว
หน้าแสดงโฟลว์จะเปิดที่อีเมลฉบับแรก ซึ่งมีช่วงรอเฉพาะด้านหลัง เมื่อเลื่อนเข้าไปตรงกลางอย่างลำดับอีเมลของ Ro ด้านบน ช่วงห่างจะแสดงทั้งสองฝั่ง โฟลว์ต้อนรับของ Ro มีจังหวะที่ช้ากว่าของ Zapier คืออีเมล 12 ฉบับในเวลา 46.7 วัน และช่วงห่างก็บอกเรื่องนี้ก่อนที่คุณจะได้อ่านหัวเรื่องแม้แต่บรรทัดเดียว
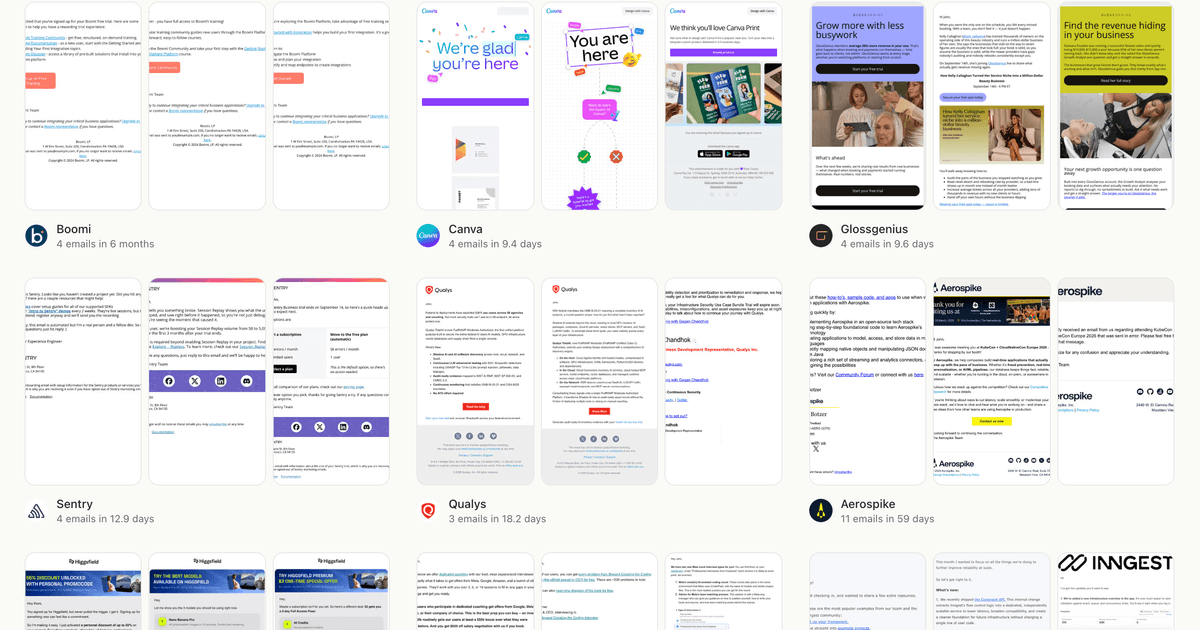
แต่ละขั้นตอนมีหัวเรื่อง ข้อความแสดงตัวอย่าง วันที่อีเมลมาถึง ระยะเวลารอนับจากการส่งครั้งก่อน หมวดหมู่ และรูปภาพตัวอย่าง และหากขอ คุณจะได้ HTML ที่แสดงผลแล้วด้วย
คลังอีเมลนี้มีลำดับอีเมล 1 ชุดต่อแบรนด์ โฟลว์ 151 รายการจึงหมายถึงบริษัท 151 แห่ง:
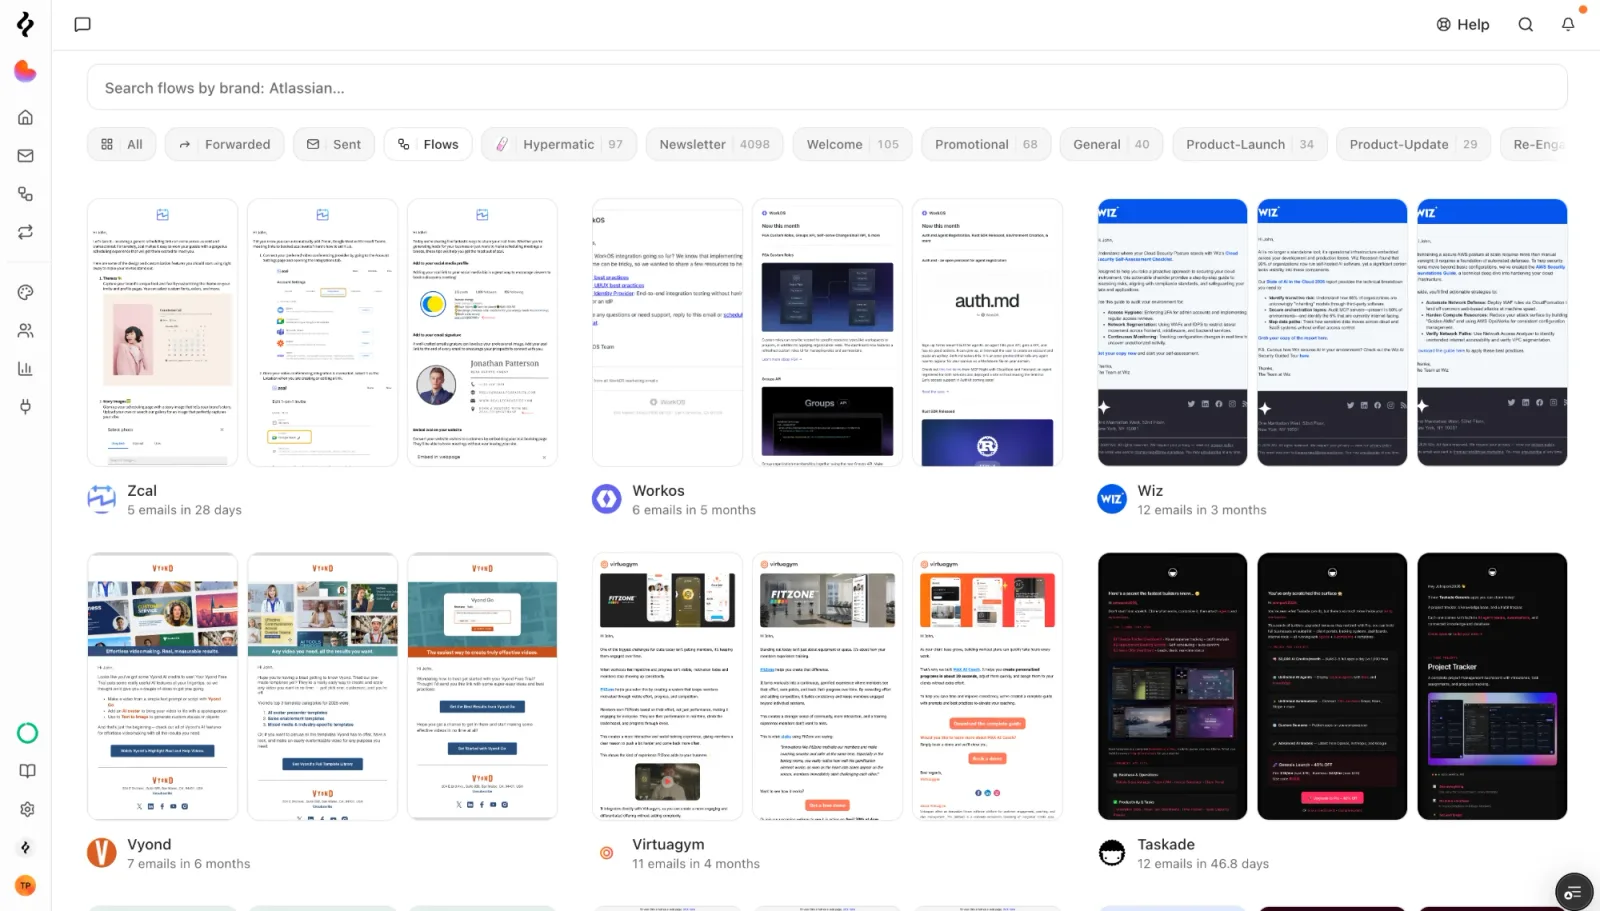
แกลเลอรีนี้อยู่คู่กับแกลเลอรีดีไซน์เดี่ยว ซึ่งมีจดหมายข่าวอีก 4,098 ฉบับ, อีเมลต้อนรับ 105 ฉบับ และอีเมลโปรโมชัน 68 ฉบับ โฟลว์คือส่วนที่บอกลำดับให้คุณรู้
หลายคนคาดว่าการรีมิกซ์คือการคัดลอก แต่ไม่ใช่
Brew สร้างกราฟของระบบอัตโนมัติก่อน เริ่มจากทริกเกอร์ของคุณ ตามด้วยช่วงห่างของโฟลว์ต้นฉบับในรูปขั้นตอนรอ แล้วจึงเป็นขั้นตอนส่งอีเมลหนึ่งขั้นสำหรับแต่ละขั้นตอนในต้นฉบับ ครึ่งนี้เป็นการคำนวณ ไม่ใช่การสร้างด้วย AI ไม่มีใครต้องขอให้โมเดลเดาว่าอีเมลฉบับที่ 4 จะส่งออกในวันที่ 3
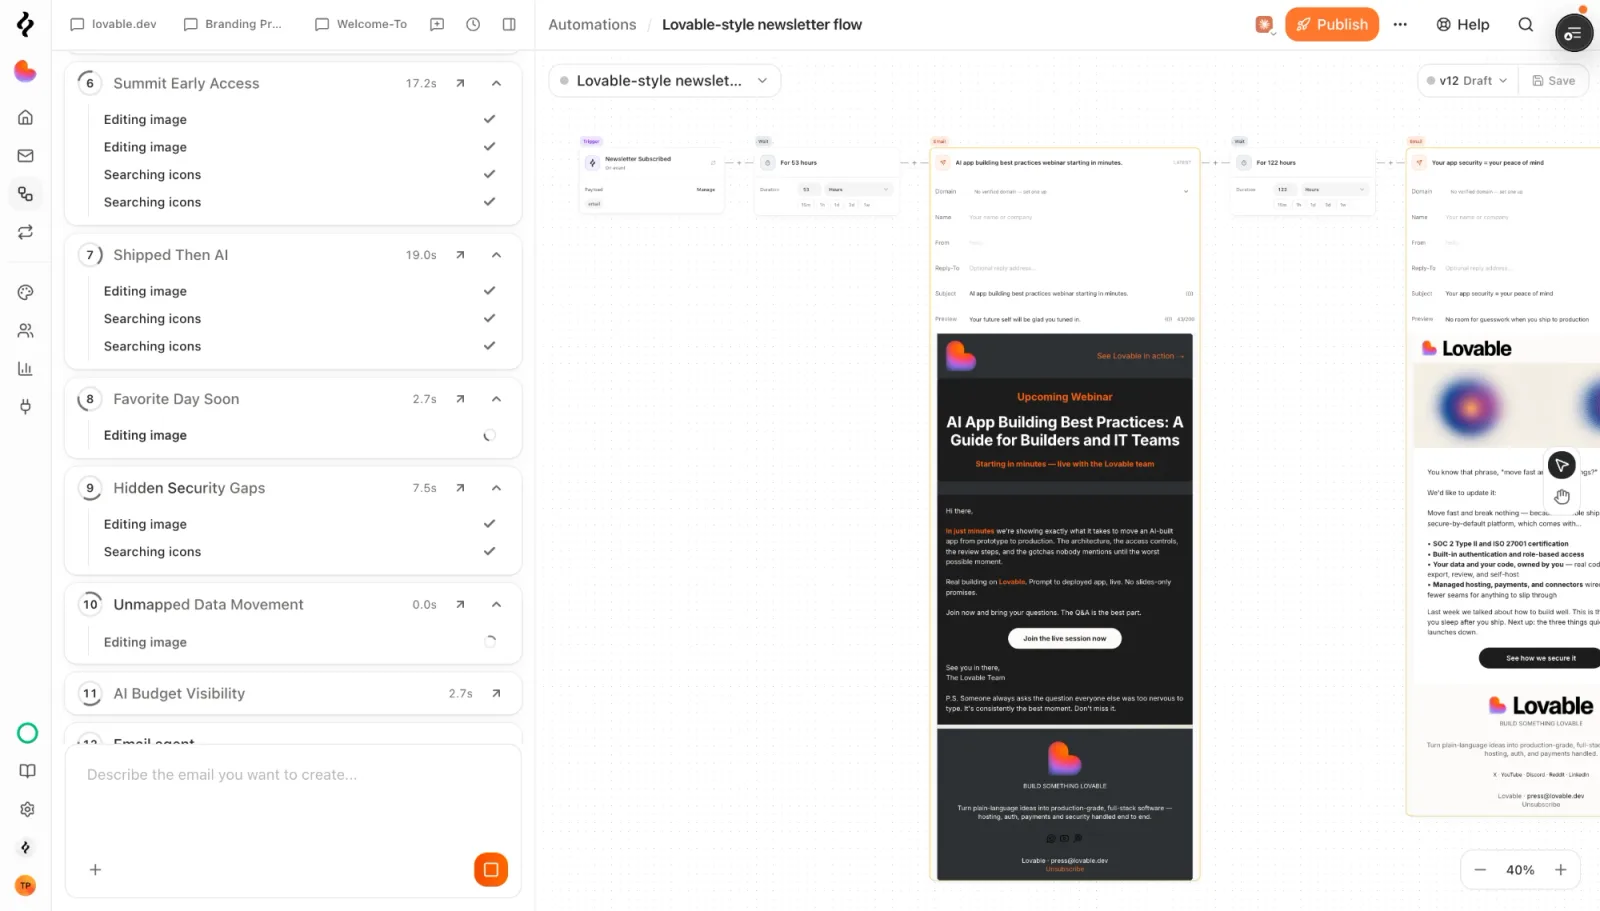
ขั้นตอนรอเหล่านั้นแสดง 53 ชั่วโมงและ 122 ชั่วโมง เพราะนั่นคือจังหวะที่แบรนด์ต้นฉบับส่งจริง โดยปัดเป็นชั่วโมงที่ใกล้ที่สุด ช่วงห่างที่เป็นจำนวนวันเต็มก็ยังคงเป็นวันเต็ม และช่วงห่างที่สั้นกว่า 1 ชั่วโมงจะกลายเป็น 1 ชั่วโมง มีเพียงอีเมลเท่านั้นที่ AI สร้างขึ้น และสร้างพร้อมกันทุกฉบับ โดยแต่ละฉบับอิงแบรนด์ของคุณ ทั้งสี ฟอนต์ น้ำเสียง และผลิตภัณฑ์ของคุณ แต่ละขั้นตอนยังได้บรีฟที่อธิบายหน้าที่ของตัวเองในลำดับอีเมล และสิ่งที่อยู่ก่อนและหลังมัน เพราะเอเจนต์ย่อย (subagent) ที่เขียนอีเมลเหล่านั้นมองไม่เห็นงานของกันและกัน หากไม่มีบรีฟ ก็จะได้ข้อความ 8 ฉบับที่ไม่เกี่ยวข้องกันเลยแต่ส่งตามตารางเวลาเดียวกัน
คุณจะได้ระบบอัตโนมัติฉบับร่างที่มีจังหวะการส่งของลำดับอีเมลที่บริษัทจริงเคยใช้มาแล้ว พร้อมข้อความที่เป็นของคุณเอง แต่คุณยังต้องอ่านตรวจเอง การปรับให้เป็นแบรนด์ของคุณนั้นทำได้ดี แต่ยังไม่ใช่งานที่เสร็จสมบูรณ์
ทุกโฟลว์เข้าถึงได้ทั้งผ่าน REST API และ MCP เอเจนต์จึงอ่านคลังอีเมลได้โดยตรง
# First page, newest first
curl "https://brew.new/api/v1/flows" \
  -H "Authorization: Bearer $BREW_API_KEY"

# One sequence, every step
curl "https://brew.new/api/v1/flows/zapier.com" \
  -H "Authorization: Bearer $BREW_API_KEY"
กรองได้ด้วย brand, category หรือ type (signup หรือ newsletter) เรียงด้วย emails เพื่อดูลำดับที่มีอีเมลมากที่สุด, span เพื่อดูลำดับที่กินระยะเวลาหลายวันที่สุด หรือ remixes เพื่อดูโฟลว์ที่คนอื่นเห็นว่าน่าหยิบไปใช้ ส่ง semantic เพื่อค้นหาตามเนื้อหาของลำดับอีเมล ซึ่งเป็นวิธีหาอีเมลดึงลูกค้ากลับหลังช่วงทดลองใช้หมดอายุ โดยไม่ต้องรู้ว่าแบรนด์ไหนเขียนไว้
การอ่านแบบเดียวกันนี้มีทั้งในรูปเครื่องมือและรีซอร์ส (resource) บนเซิร์ฟเวอร์ MCP ของ Brew:
list_flows                      # the list, same filters and sorts
get_flow { slug: "zapier.com" } # one sequence with every step
brew://flows                    # @-mentionable in a chat
REST และ MCP อ่านแคตตาล็อกสาธารณะชุดเดียวกัน โฟลว์เป็นข้อมูลระดับองค์กร การอ่านเหล่านี้จึงไม่ต้องระบุแบรนด์ สำหรับการแบ่งหน้าของรายการ ให้ส่ง pagination.cursor ที่ได้กลับมาเป็น cursor ของคำขอถัดไป จนกว่าค่าจะเป็น null คำขอรายการครั้งเดียวไม่ได้ส่งคืนแคตตาล็อกทั้งหมด แต่ total ของคำขอนั้นนับทุกโฟลว์ที่ตรงกับคำค้น
เอเจนต์ตรวจดูลำดับอีเมลได้ก่อนเลือกอีเมลอ้างอิง
โฟลว์หลังสมัครแบบไหนใส่ส่วนลดไว้ในอีเมลฉบับแรก และแบบไหนรอจนช่วงทดลองใช้ใกล้หมด? เครื่องมือสำหรับนักพัฒนาส่งอะไรในวันที่ 2? ลำดับอีเมลต้อนรับของจดหมายข่าวส่งต่อเนื่องนานเท่าไรก่อนจะหยุด? ลำดับอีเมลกี่ชุดที่เปิดด้วยคำถามแทนที่จะเปิดด้วยประโยชน์ที่ผู้อ่านจะได้รับ? ข้อมูลเหล่านี้ช่วยให้เอเจนต์สำรวจคำถามเหล่านั้นได้ด้วยการอ่าน steps[] แต่การวิเคราะห์หัวเรื่องและเนื้อหายังต้องอาศัยการตีความ เพราะ API ไม่มีตัวกรองสำหรับทุกคำถาม
สิ่งที่ทำให้ข้อมูลนี้กลายเป็นวัตถุดิบอ้างอิงที่ใช้งานได้คือ emailId ในแต่ละขั้นตอน ซึ่งเป็นตัวอ้างอิงแบบเดียวกับที่แกลเลอรีเทมเพลตใช้ และเป็นสิ่งที่ create_email รับเป็น referenceEmailId พอดี เอเจนต์จึงอ่านเส้นเรื่องของลำดับอีเมล เลือกขั้นตอนที่สำคัญ แล้วส่งอีเมลฉบับนั้นต่อให้เครื่องมือออกแบบ:
get_flow { slug: "zapier.com" }
  → steps[4].emailId = "pt1_k97hmahabyjrp1yfmga8m1rhah8e572q"

create_email {
  referenceEmailId: "pt1_k97hmahabyjrp1yfmga8m1rhah8e572q",
  prompt: "day-5 activation email for our API product"
}
ศึกษาเส้นเรื่อง ดึงอีเมลฉบับที่ต้องการ แล้วสร้างเวอร์ชันของคุณเอง โดยไม่ต้องคัดลอกและวางเลยสักครั้ง
การเก็บอีเมลเก็บได้สูงสุด 12 ฉบับต่อโฟลว์และตัดส่วนท้ายทิ้ง emailCount: 12 จึงหมายถึงมีการส่ง 12 ฉบับขึ้นไป ไม่ใช่ 12 ฉบับพอดี ซึ่งก็คือ 59 โฟลว์ที่กล่าวไว้ข้างต้น
อีเมลที่แสดงผลแล้วมีขนาดใหญ่ การขอ HTML ผ่าน MCP จะได้มาเพียง 1 หรือ 2 ขั้นตอนแรกก่อนที่คำตอบจะเต็ม ส่วนขั้นตอนที่เหลือจะมาโดยไม่มี HTML และบทสรุปจะบอกว่าเก็บไว้ได้กี่ขั้นตอน เส้นทาง REST ไม่มีเพดานแบบนี้ หากต้องการเนื้อหาทุกฉบับ ให้อ่านโฟลว์ผ่านเส้นทางนั้น: GET /v1/flows/zapier.com?include=html
เปิดแกลเลอรีแล้วอ่านลำดับอีเมล 3 ชุดในหมวดเดียวกับคุณก่อนจะเริ่มเขียน จากนั้นรีมิกซ์ชุดที่คุณมั่นใจพอจะอธิบายจังหวะการส่งให้ทีมของคุณยอมรับได้ แล้วเปลี่ยนส่วนที่ไม่เหมาะ
หากคุณให้เอเจนต์ใช้ข้อมูลนี้ การเรียก list_flows โดยไม่ใส่อาร์กิวเมนต์คือการเรียกครั้งแรกที่ถูกต้อง เพราะจะคืนการ์ดพร้อม slug และ slug คือสิ่งเดียวที่ get_flow ต้องใช้เพื่อดึงข้อมูลที่เหลือทั้งหมด ดูรายการฟิลด์ทั้งหมดได้ในเอกสารอ้างอิง API
อีเมลทุกฉบับที่แบรนด์หนึ่งส่งหลังการสมัครใช้งานหรือการสมัครรับจดหมายข่าวหนึ่งครั้ง เรียงตามลำดับ พร้อมวันที่อีเมลแต่ละฉบับมาถึงนับจากทริกเกอร์นั้น แต่ละแบรนด์มีโฟลว์เดียว และ slug ของโฟลว์คือโดเมนของแบรนด์
ไม่คัดลอก เพราะ Brew คัดลอกเฉพาะโครงสร้าง ได้แก่ จำนวนขั้นตอน ลำดับ และช่วงห่าง ซึ่งจำลองให้ละเอียดถึงระดับชั่วโมง จากนั้นจึงสร้างอีเมลทุกฉบับขึ้นใหม่ตามแบรนด์ของคุณ โดยใช้ดีไซน์ต้นฉบับเป็นข้อมูลอ้างอิง ผลลัพธ์จึงใช้สี ฟอนต์ และน้ำเสียงของคุณ
การอ่านผ่าน REST ต้องใช้คีย์ API ที่มีขอบเขต templates.read ส่วน MCP รองรับ OAuth หรือคีย์ API ที่มีสิทธิ์เข้าถึงที่เหมาะสม ทั้งนี้ ตัวแกลเลอรีเป็นสาธารณะและไม่ต้องมีบัญชี
สูงสุด 12 ฉบับ การเก็บอีเมลจะเก็บ 12 ฉบับแรกแล้วตัดส่วนท้ายทิ้ง โฟลว์ที่แสดงว่ามีอีเมล 12 ฉบับจึงอาจส่งต่อเนื่องนานกว่านั้น โดยโฟลว์ที่เผยแพร่แล้ว 59 จาก 151 รายการอยู่ที่เพดานนี้
ได้ โดยใส่ include=html เมื่ออ่านโฟลว์ทีละรายการ หากอ่านผ่าน MCP จะมีเพียง 1 หรือ 2 ขั้นตอนแรกที่ใส่ในคำตอบเดียวได้ และบทสรุปจะบอกว่าเก็บไว้ได้กี่ขั้นตอน ส่วนเส้นทาง REST จะคืนเนื้อหาครบทุกฉบับ

