
151 echte e-mailreeksen met de dag waarop elk bericht binnenkwam. Bekijk ze, remix er een tot een conceptautomatisering of lees ze allemaal via de API en MCP.

De meeste sjablonengalerijen laten je één e-mail tegelijk zien. Dat is de minst bruikbare eenheid. Eén welkomstmail laat niet zien wanneer die verstuurd wordt of wat eromheen gebeurt. De reeks voegt die context toe, al bewijst het zien van een reeks nog niet dat die goed heeft gepresteerd.
Daarom hebben we de reeksen bewaard die we hebben vastgelegd. Een flow in Brew toont de e-mails die we na een aanmelding of inschrijving voor een nieuwsbrief hebben waargenomen, op volgorde, met de dag waarop elke e-mail binnenkwam. Door de grenzen van het vastleggen bevat een flow mogelijk niet de hele reeks. Bij de lancering op 17 september stonden er 151 flows in de galerij. De aantallen hieronder beschrijven die momentopname bij de lancering; de live catalogus kan veranderen.
GET /v1/flows en de MCP-tool list_flows geven dezelfde records terug, dus een agent kan alle 151 reeksen bestuderen zonder dat iemand ergens op hoeft te klikken.emailId die je rechtstreeks als referenceEmailId aan create_email kunt meegeven.De reeks die Zapier na een aanmelding verstuurt, telt acht e-mails in 10,7 dagen:
| Dag | Onderwerpregel |
|---|---|
| 0 | Welcome aboard 👋 | Let's make some magic with AI |
| 1 | Why you should ditch spreadsheets for Tables |
| 2 | Build your first Zap workflow with Copilot ⚡ |
| 3 | What engineers are automating this week |
| 5 | Put AI to work for you |
| 9 | Go beyond workflows 🚀 |
| 10 | Stuck? Or need automation ideas? |
| 10,7 | Your Zapier trial ends in three days ⏲️ |
Lees de dagen, niet alleen de onderwerpregels. Vier e-mails komen op opeenvolgende ochtenden binnen, daarna wordt de tussenpoos twee dagen, en vervolgens vier. De e-mail “Stuck?” komt op dag 10 en de e-mail over het aflopen van de proefperiode volgt zeventien uur later. Iemand heeft besloten dat het laatste nuttige vóór een betaalmuur een aanbod van hulp is, en dat die twee elkaar bijna moeten raken.
Dat zie je niet op een screenshot van één e-mail.
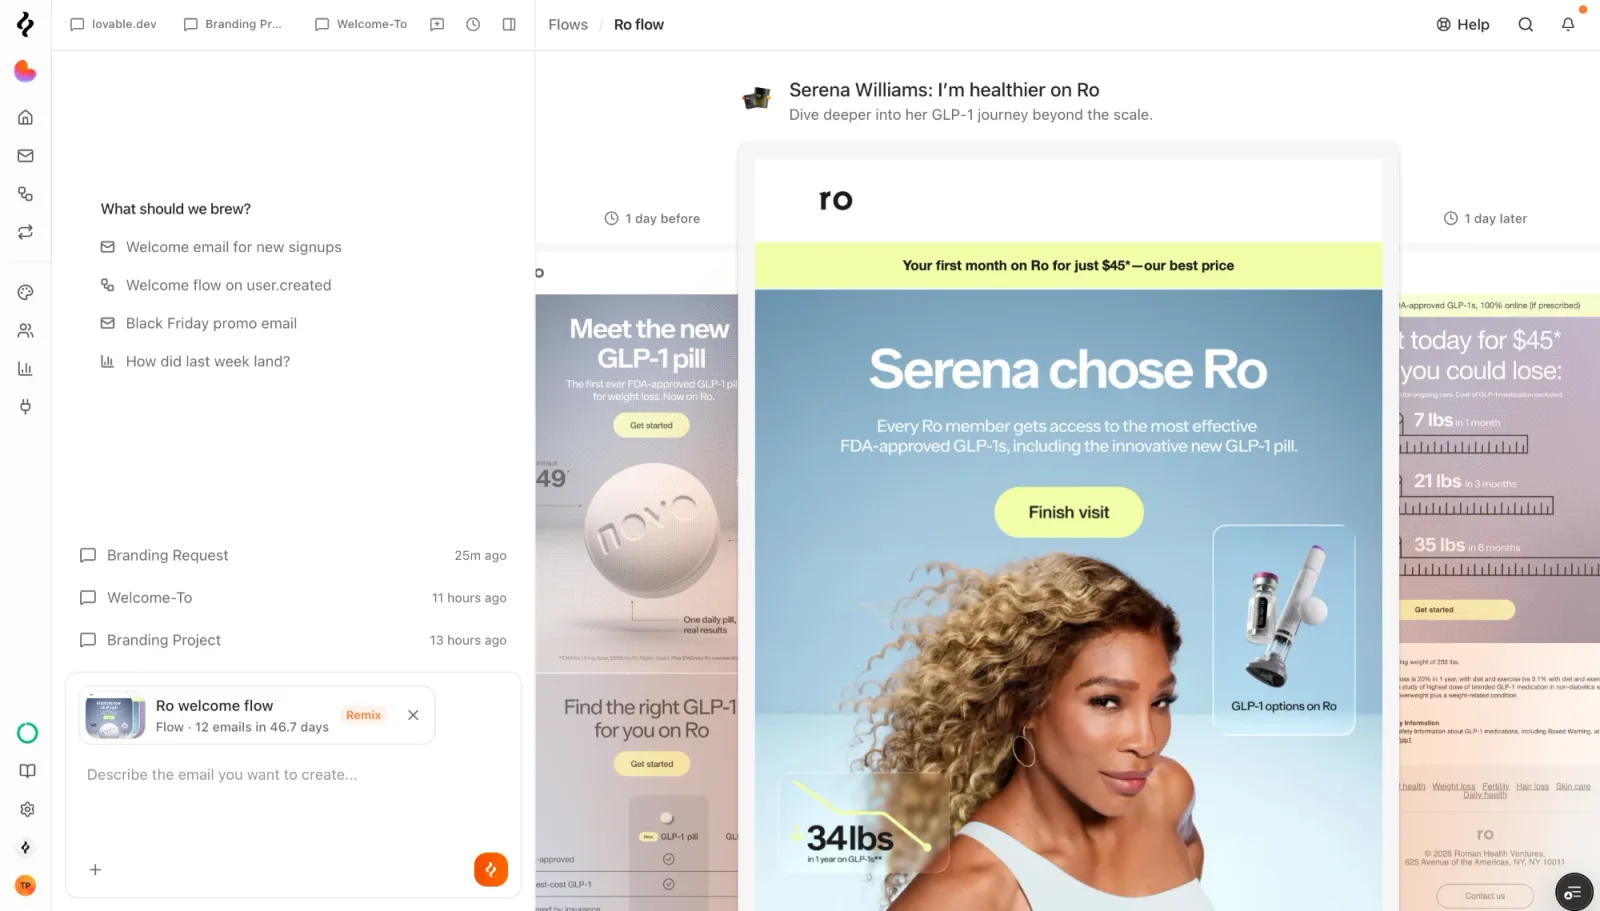
De viewer opent op de eerste e-mail; daar zie je alleen de wachttijd erna. Stap je in het midden in, zoals in de reeks van Ro hierboven, dan zie je de tussenpoos aan beide kanten. De welkomstflow van Ro heeft een trager verloop dan die van Zapier, 12 e-mails in 46,7 dagen, en dat verraden de tussenpozen al voordat je ook maar één onderwerpregel hebt gelezen.
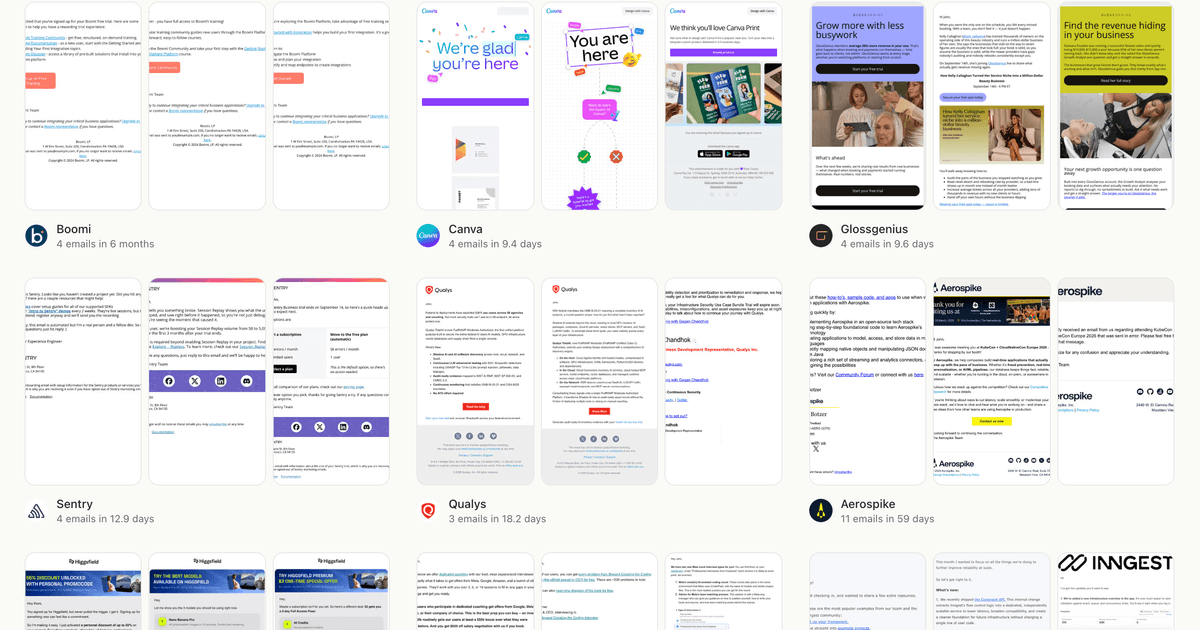
Elke stap bevat de onderwerpregel, de previewtekst, de dag waarop de e-mail binnenkwam, de wachttijd sinds de vorige verzending, een categorie en een voorbeeldafbeelding. Vraag je erom, dan krijg je ook de gerenderde HTML.
Het corpus bevat één reeks per merk, dus 151 flows betekent 151 bedrijven:
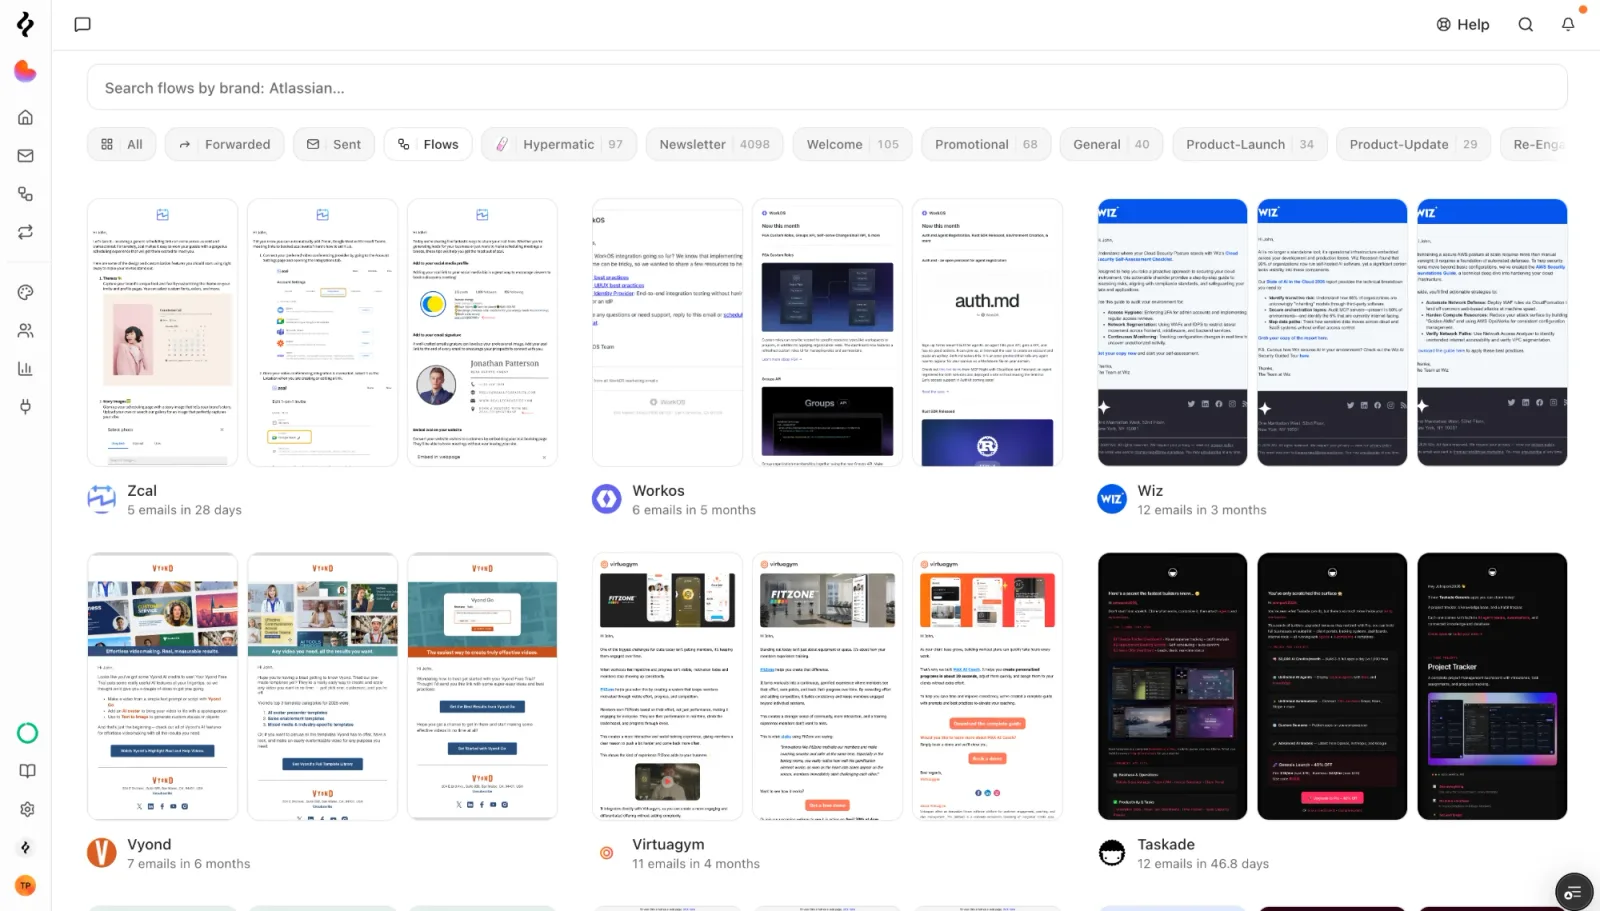
Daarnaast is er de galerij met losse ontwerpen, met nog eens 4.098 nieuwsbrieven, 105 welkomstmails en 68 promotiemails. De flows zijn het deel dat je de volgorde vertelt.
Bij remixen verwachten mensen een kopie. Dat is het niet.
Brew bouwt eerst de structuur van de automatisering: je trigger, dan de tussenpozen uit de bronflow als wachtstappen, en daarna één verzendstap voor elke stap uit de bron. Die helft is rekenwerk, geen generatie. Niemand vraagt een model om te raden dat de vierde e-mail op dag drie uitgaat.
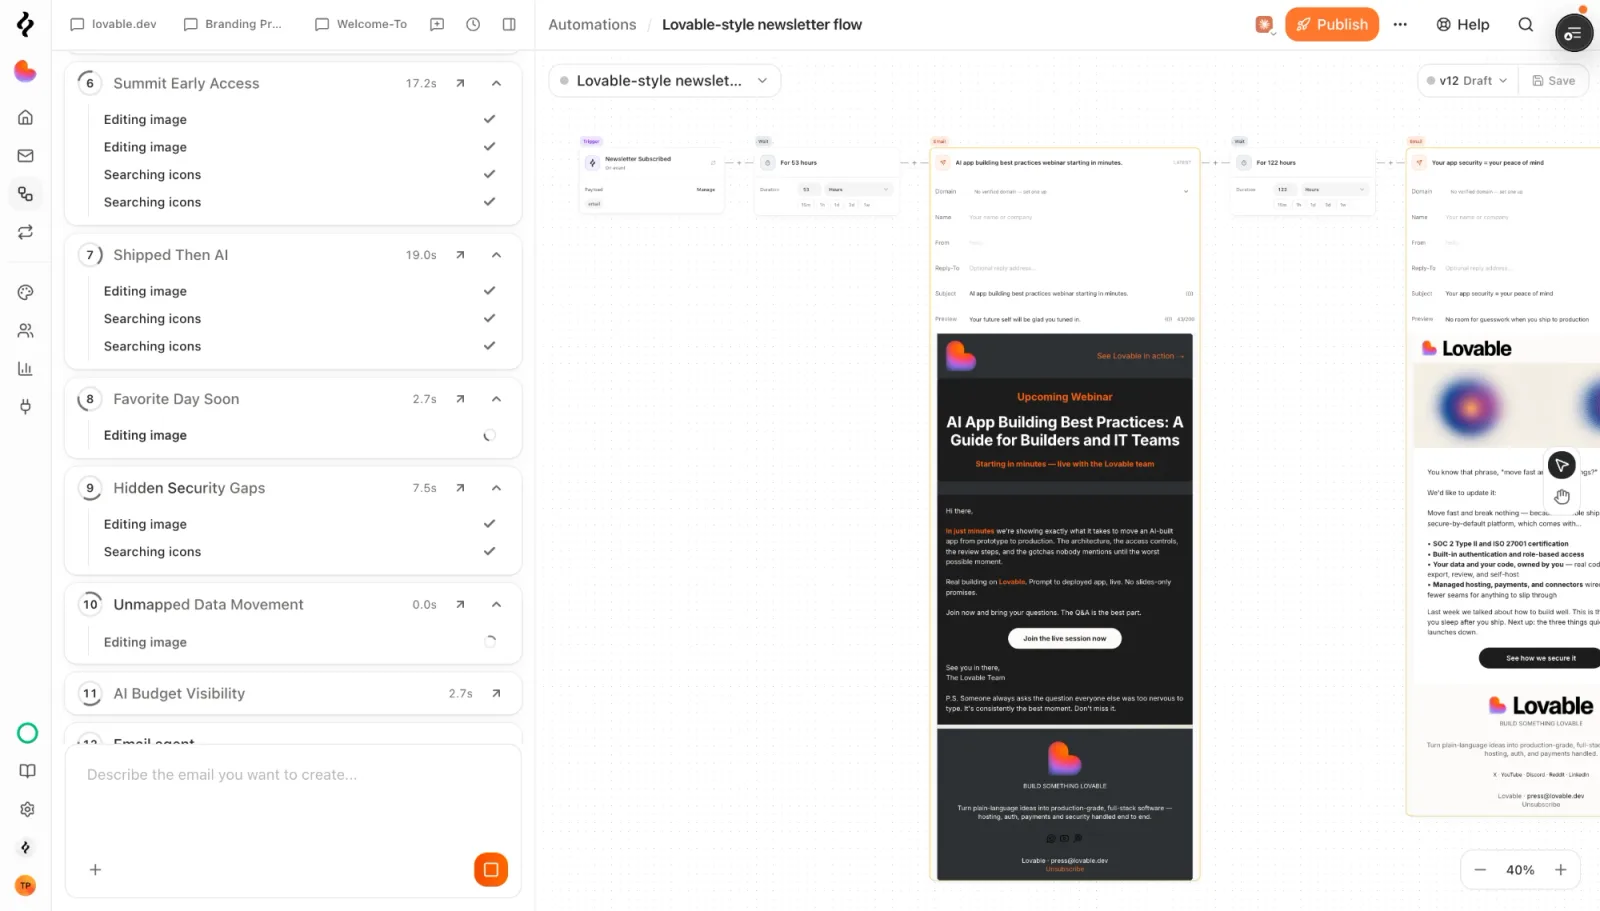
Op die wachtstappen staat 53 uur en 122 uur, omdat het bronmerk zo verstuurde, afgerond op het dichtstbijzijnde uur. Een tussenpoos van een hele dag blijft een hele dag, en alles onder een uur wordt één uur. Alleen de e-mails worden gegenereerd, en dat gebeurt parallel, elke e-mail voor jouw merk. Jouw kleuren, jouw lettertypen, jouw tone of voice, jouw product. Elke stap krijgt ook een briefing over zijn rol in de reeks en over wat ervoor en erna komt, want de subagents die die e-mails schrijven, zien elkaars werk niet en zouden anders acht losse berichten maken die alleen een schema delen.
Je krijgt een conceptautomatisering met het tempo van een reeks die een echt bedrijf al heeft gedraaid, en teksten die van jou zijn. Je moet ze nog wel lezen. De rebranding is goed, maar niet af.
Elke flow is beschikbaar via de REST-API en via MCP, dus een agent kan het corpus rechtstreeks lezen.
# First page, newest first
curl "https://brew.new/api/v1/flows" \
  -H "Authorization: Bearer $BREW_API_KEY"

# One sequence, every step
curl "https://brew.new/api/v1/flows/zapier.com" \
  -H "Authorization: Bearer $BREW_API_KEY"
Filter op brand, category of type (signup of newsletter). Sorteer op emails voor de reeksen met de meeste e-mails, op span voor de reeksen die zich over de meeste dagen uitstrekken, of op remixes voor wat anderen het kopiëren waard vonden. Geef semantic mee om te zoeken op waar een reeks over gaat. Zo vind je een terugwinmail rond het aflopen van een proefperiode zonder te weten welk merk er een schreef.
Op de MCP-server van Brew is dezelfde read beschikbaar als tool en als resource:
list_flows                      # the list, same filters and sorts
get_flow { slug: "zapier.com" } # one sequence with every step
brew://flows                    # @-mentionable in a chat
REST en MCP lezen dezelfde openbare catalogus. Flows gelden voor de hele organisatie, dus bij deze reads geef je geen merk mee. Voor paginering geef je de teruggegeven pagination.cursor mee als cursor van het volgende verzoek, tot die null is. Eén lijstverzoek geeft niet de hele catalogus terug, maar total telt wel elke flow die met de query overeenkomt.
Een agent kan de reeks bekijken voordat die een referentie kiest.
Welke aanmeldflows zetten een korting in de eerste e-mail, en welke wachten tot de proefperiode bijna voorbij is? Wat sturen developertools op dag twee? Hoe lang lopen welkomstreeksen voor nieuwsbrieven voordat ze stoppen? Hoeveel reeksen openen met een vraag in plaats van een voordeel? Met de records kan een agent die vragen onderzoeken door steps[] te lezen. De analyse van onderwerpregels en inhoud vraagt nog steeds om interpretatie; de API heeft niet voor elke vraag een filter.
Wat dit tot bruikbaar referentiemateriaal maakt, is de emailId bij elke stap. Het is dezelfde verwijzing die de sjablonengalerij gebruikt, en precies wat create_email als referenceEmailId verwacht. Een agent leest dus het verloop, kiest de stap die ertoe doet en geeft die ene e-mail door aan de ontwerptool:
get_flow { slug: "zapier.com" }
  → steps[4].emailId = "pt1_k97hmahabyjrp1yfmga8m1rhah8e572q"

create_email {
  referenceEmailId: "pt1_k97hmahabyjrp1yfmga8m1rhah8e572q",
  prompt: "day-5 activation email for our API product"
}
Bestudeer het verloop, haal de specifieke e-mail op en bouw je eigen versie. Zonder kopiëren en plakken tussendoor.
We leggen per flow maximaal twaalf e-mails vast en laten de rest weg, dus emailCount: 12 betekent dat er twaalf of meer zijn verstuurd, niet precies twaalf. Dat zijn de 59 flows van hierboven.
Gerenderde e-mail is omvangrijk. Vraag je via MCP om HTML, dan krijg je die voor de eerste één of twee stappen voordat het antwoord vol zit, en komt de rest zonder HTML. In de samenvatting staat hoeveel er zijn meegestuurd. De REST-route heeft zo’n limiet niet, dus lees de flow daar als je elke body wilt: GET /v1/flows/zapier.com?include=html.
Open de galerij en lees drie reeksen in je eigen categorie voordat je iets schrijft. Remix daarna de reeks met het tempo dat je tegenover je eigen team zou verdedigen, en pas aan wat niet past.
Zet je hier een agent op in, dan is list_flows zonder argumenten de juiste eerste aanroep. Die geeft kaarten met slugs terug, en de slug is het enige wat get_flow voor de rest nodig heeft. De volledige lijst met velden staat in de API-referentie.
Elke e-mail die één merk verstuurde na één aanmelding of inschrijving voor de nieuwsbrief, op volgorde, met de dag waarop elke e-mail binnenkwam ten opzichte van die trigger. Eén flow per merk, en de slug van de flow is het domein van het merk.
Nee. Brew kopieert de structuur: het aantal stappen, de volgorde en de tussenpozen, afgerond op het dichtstbijzijnde uur. Daarna wordt elke e-mail opnieuw opgebouwd voor je merk, met het oorspronkelijke ontwerp als referentie, zodat het resultaat jouw kleuren, lettertypen en tone of voice heeft.
Voor reads via REST heb je een API-sleutel met templates.read nodig. MCP ondersteunt OAuth of een API-sleutel met de juiste toegang. De galerij zelf is openbaar en vereist geen account.
Maximaal twaalf. We leggen de eerste twaalf vast en laten de rest weg, dus een flow met twaalf e-mails kan langer hebben gelopen. 59 van de 151 gepubliceerde flows zitten op dat plafond.
Ja, met include=html als je één flow uitleest. Via MCP passen alleen de eerste één of twee stappen in één antwoord, en de samenvatting vertelt je hoeveel er zijn meegestuurd. De REST-route geeft elke body terug.

